


Por qué prever un modo degradado
Uso una IA en línea para mis proyectos personales, por las tardes y los fines de semana: programar, redactar, hacer SEO en mis webs. El día que el router falla, todo se para. Un corte de Internet no debería bloquear más mis proyectos.
Ya había instalado una IA local para programar (Qwen 2.5 Coder 3B con Ollama). Esta vez fui más lejos: un pequeño equipo de 4 modelos, cada uno con su papel, que trabajan uno tras otro en la misma tarea.
El resultado no iguala a una IA en línea. Pero permite seguir avanzando en modo degradado, gratis y sin que ningún dato salga de mi PC.
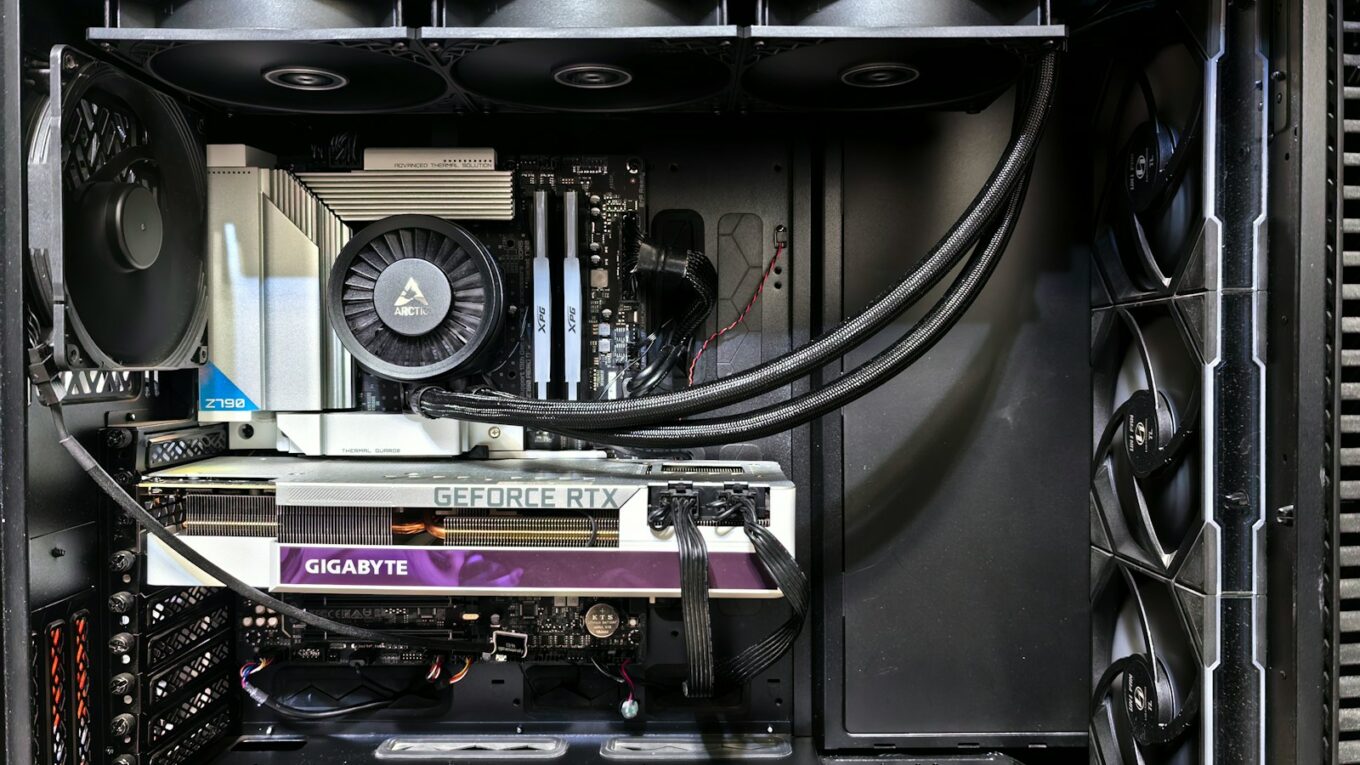
Mi configuración: 4 GB de VRAM, el verdadero límite
| Componente | Modelo |
|---|---|
| Procesador | Intel Core i5-11400F (6 núcleos, 12 hilos) |
| Memoria RAM | 32 GB |
| Tarjeta gráfica | NVIDIA GTX 1650 Super, 4 GB de VRAM |
| Sistema | Windows, con Ollama y VS Code |
La memoria de la tarjeta gráfica lo decide todo. Un modelo que cabe entero en los 4 GB responde rápido. Si se desborda, una parte pasa al procesador y la velocidad cae.
De ahí salen dos reglas:
- modelos de 2 a 4 mil millones de parámetros para el trabajo diario;
- un solo modelo cargado a la vez, para no saturar nunca la tarjeta gráfica.
Los 4 modelos y el papel de cada uno
Cada modelo tiene un punto fuerte, y la cadena los combina.
| Modelo | Comando Ollama | Papel en la cadena | Por qué este |
|---|---|---|---|
| Qwen 3.5 4B | qwen3.5:4b |
Planificar y luego finalizar | El mejor razonamiento en este tamaño, con un modo de «reflexión» activable |
| Gemma 4 E2B | gemma4:e2b |
Redactar | Ligero, cómodo redactando, y también lee imágenes |
| Phi-4 Mini | phi4-mini |
Revisar y criticar | Entrenado en lógica: una mirada distinta a la de los Qwen |
| Qwen 3.5 9B | qwen3.5:9b |
Refuerzo para tareas difíciles | Más inteligente, pero desborda la tarjeta: más lento |
Mantuve Qwen 2.5 Coder 3B para el autocompletado en VS Code, y añadí nomic-embed-text, un modelo pequeño que sirve para buscar en el código de un proyecto.
Instalar los modelos con un solo comando
Con Ollama ya instalado, una sola línea de PowerShell descarga todo el equipo:
"qwen3.5:4b", "gemma4:e2b", "phi4-mini", "qwen3.5:9b", "nomic-embed-text" | ForEach-Object { ollama pull $_ }Hay que prever unos 15 GB de espacio en disco. Si la descarga se interrumpe, basta con volver a lanzar el comando: los modelos ya presentes no se descargan de nuevo.
Para comprobar que todo está:
ollama listHazlo antes del corte: esta descarga necesita Internet. El modo degradado se prepara cuando todo funciona.
Respuestas directas, sin esquema
En modo reflexión, Qwen 3.5 escribe un largo razonamiento antes de responder. Para el uso diario, creé una variante que responde directamente:
@"
FROM qwen3.5:4b
SYSTEM "Responde en español, de forma directa y breve. Sin esquema, sin introducción."
"@ | Out-File -Encoding utf8 Modelfile

ollama create qwen-rapido -f Modelfile
ollama run qwen-rapido --think=false
Hacer que las IA trabajen una tras otra
Un pequeño script de Python pasa la tarea de un modelo a otro, y retira cada modelo de la tarjeta gráfica en cuanto termina. Así nunca hay dos en memoria al mismo tiempo.
La cadena sigue cuatro pasos:
- Qwen 3.5 4B divide la petición en un plan corto.
- Gemma 4 E2B redacta siguiendo ese plan.
- Phi-4 Mini revisa y enumera los errores y los olvidos.
- Qwen 3.5 4B corrige el texto a partir de la crítica y entrega la versión final.
Cada modelo recibe el trabajo de los anteriores. El resultado completo se guarda en un archivo resultado.md.
El script
Solo usa Python estándar: nada más que instalar. Dos parámetros hacen todo el trabajo: keep_alive: 0 libera la tarjeta gráfica después de cada respuesta, y think: False evita los razonamientos largos.
import json, sys, urllib.request

OLLAMA_URL = "http://localhost:11434/api/chat"

PASOS = [
    ("Planificador", "qwen3.5:4b",
     "Eres un planificador. Divide la petición en un plan corto y concreto (5 puntos máximo)."),
    ("Redactor", "gemma4:e2b",
     "Eres un redactor. Produce el trabajo pedido siguiendo el plan proporcionado."),
    ("Crítico", "phi4-mini",
     "Eres un revisor exigente. Enumera los errores, olvidos y mejoras posibles. Sé breve."),
    ("Finalizador", "qwen3.5:4b",
     "Eres el editor final. Corrige el trabajo teniendo en cuenta la crítica. "
     "Entrega solo la versión final."),
]

def llamar(modelo, sistema, mensaje):
    cuerpo = json.dumps({
        "model": modelo,
        "messages": [
            {"role": "system", "content": sistema + " Responde en español."},
            {"role": "user", "content": mensaje},
        ],
        "stream": False,
        "think": False,
        "keep_alive": 0,
    }).encode("utf-8")
    req = urllib.request.Request(OLLAMA_URL, data=cuerpo,
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=900) as resp:
        return json.loads(resp.read())["message"]["content"].strip()

peticion = sys.argv[1]
contexto = f"PETICIÓN:\n{peticion}"
resultados = {}
for nombre, modelo, papel in PASOS:
    print(f"\n=== {nombre} ({modelo}) en curso... ===")
    respuesta = llamar(modelo, papel, contexto)
    resultados[nombre] = respuesta
    print(respuesta)
    contexto += f"\n\n--- {nombre.upper()} ---\n{respuesta}"

with open("resultado.md", "w", encoding="utf-8") as f:
    f.write(f"# Petición\n{peticion}\n\n")
    for nombre, texto in resultados.items():
        f.write(f"## {nombre}\n{texto}\n\n")
Lanzarlo
py agents.py "Redacta un artículo de 600 palabras sobre el alquiler de un fotomatón para una boda"Para cambiar la cadena, basta con modificar la lista PASOS: añadir un paso, cambiar un papel o confiar la finalización a qwen3.5:9b para ganar calidad.
Los mismos modelos en VS Code
En VS Code, la extensión Continue usa los modelos de Ollama sin conexión. Allí repartí los papeles: el modelo pequeño de código para el autocompletado, Qwen 3.5 para el chat.
Archivo config.yaml de Continue (en %USERPROFILE%\.continue\):
name: IA local
version: 1.0.0
schema: v1
models:
  - name: Qwen Coder 3B (local)
    provider: ollama
    model: qwen2.5-coder:3b
    roles:
      - autocomplete
      - apply
  - name: Qwen Rapido
    provider: ollama
    model: qwen-rapido
    roles:
      - chat
      - edit
  - name: Nomic Embed
    provider: ollama
    model: nomic-embed-text
    roles:
      - embed
Con nomic-embed-text, Continue también puede buscar en todo el proyecto con @codebase.
Lo que da de sí, y sus límites
El modo degradado cumple: puedo seguir programando, redactando y estructurando contenido para mis proyectos personales durante un corte. Pero hay que aceptar un nivel por debajo de una IA en línea.
Lo que funciona bien
- Entender y depurar un fragmento de código, una regla .htaccess, una consulta SQL.
- Producir un primer borrador de artículo, etiquetas title y meta, una estructura de encabezados.
- Reformular un texto o un correo.
- Trabajar con contenidos confidenciales: nada sale del PC.
Los límites
- Velocidad: la cadena encadena cuatro modelos y los recarga en cada paso. En mi equipo, la cadena completa tardó 6 min 55 s en producir un artículo de unas 1000 palabras.
- Modo reflexión: activado, hace que Qwen sea mucho más lento. Lo reservo para las preguntas difíciles.
- Conocimientos: estos modelos pequeños se inventan datos con facilidad y no tienen información reciente. Todo lo factual se comprueba cuando vuelve la conexión.
- Contexto: con 4 GB de VRAM, es imposible darles documentos largos.
Mis consejos
- Instalar y probar todo antes de necesitarlo.
- Comprobar con
ollama psque el modelo funciona al 100 % en la tarjeta gráfica. - Cerrar los juegos y el navegador mientras la cadena funciona, para liberar VRAM.
La prueba: hice que mis IA locales escribieran este artículo
La cadena aguantó técnicamente, pero el texto producido no era publicable. Di a los 4 modelos un solo tema: escribir un artículo de 1000 palabras sobre esta instalación. Tardaron 6 min 55 s, uno tras otro, sin saturar la tarjeta gráfica.
No respetaron sus papeles
- El planificador redactó el artículo entero en lugar de un plan.
- El crítico lo reescribió todo en lugar de enumerar los problemas.
- El finalizador comentó el texto en lugar de entregar la versión final.
Inventos técnicos
- Un «protocolo LLM-STD» que no existe.
- Una opción
--numbaque tampoco existe. - «Q4 es imposible con 4 GB»: falso, mi Qwen 4B funciona precisamente en Q4.
- «Ollama encadena los pasos solo»: falso, lo hace mi script.
- Una «semana de corte» que nunca viví.
Conocimientos desfasados: el finalizador, que es un Qwen 3.5, afirmó que Gemma 4 y Qwen 3.5 «todavía no existen». Sus conocimientos se detienen antes de su lanzamiento.
Por qué
Les había dado un tema, no los hechos. Un modelo pequeño que no sabe rellena los huecos inventando. Unas instrucciones de papel demasiado flexibles y un historial cada vez más largo hicieron el resto.
Lo que me llevo
Yo aporto los hechos, la IA local les da forma.
| Mi IA local es fiable para | No es fiable para |
|---|---|
| Reformular o acortar un texto que he escrito | Escribir un artículo a partir de un simple tema |
| Estructurar mis notas en párrafos y encabezados | Hablar de tecnología reciente |
| Proponer títulos, meta descripciones y encabezados | Respetar papeles complejos en una cadena |
| Revisar la ortografía y la redacción | Dar datos sin verificar |
| Entender y depurar código |
Preguntas frecuentes
¿Hace falta una tarjeta gráfica potente para usar varias IA locales?
No. Si trabajan una tras otra, basta con una tarjeta de 4 GB, porque solo hay un modelo cargado a la vez.
¿Las IA locales funcionan de verdad sin Internet?
Sí. Una vez descargados los modelos, Ollama, Continue y el script funcionan totalmente sin conexión.
¿Por qué usar varios modelos en lugar de uno solo?
Cada modelo pequeño tiene sus puntos fuertes. Hacer que se revisen entre sí corrige parte de los errores que un modelo solo dejaría pasar.
¿Sustituye a una IA en línea?
No. Es un modo degradado: útil para seguir avanzando, pero más lento y menos fiable.
¿Cuánto espacio en disco hace falta?
Unos 15 GB para los cinco modelos presentados aquí.
Conclusión
Con cuatro modelos pequeños, Ollama y un script de unas cincuenta líneas, un corte de Internet ya no bloquea mis proyectos personales. El resultado sigue por debajo de una IA en línea, pero es gratis, privado y siempre está disponible. Dos lecciones: prepararlo todo antes del corte, y seguir siendo el autor. Durante un corte, la IA local es una asistente de redacción, no una redactora.